你的音色可以被数字化——Qwen3 TTS 最被低估的功能
你的音色可以被数字化——Qwen3 TTS 最被低估的功能
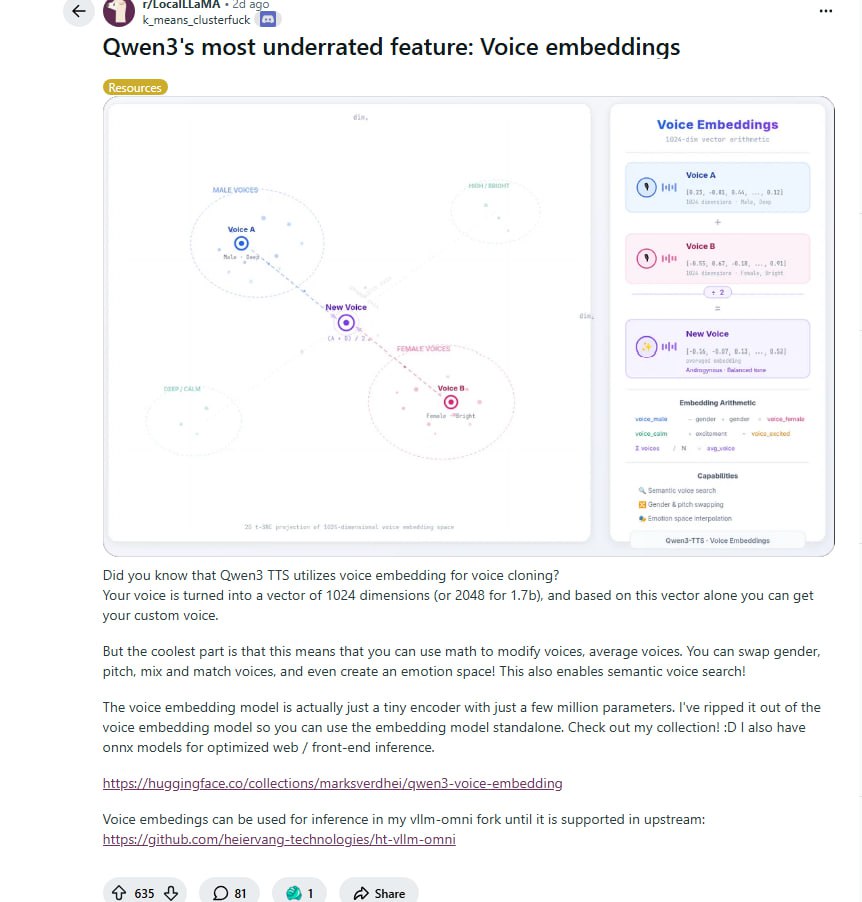
Qwen3 TTS 内置了一个声音嵌入(voice embedding)系统,能把任何人声压缩成一串数字向量,然后用数学运算来克隆、混合、改变声音。这个功能几乎没被官方重点宣传,但开发者社区已经开始玩出花样了。
一个人的声音,可以被压缩成 1024 个数字
这就是 Qwen3 TTS 里藏着的 voice embedding 系统。你说一句话,模型把它编码成一个高维向量,之后所有的声音操作,都在这串数字上完成。
这意味着什么?
- 声音变成了坐标。两个声音之间可以插值,就像在地图上找两点之间的路径
- 性别、音调、情绪,都可以通过调整某些维度来修改
- 你甚至可以把十个声音平均一下,合成一个现实里不存在的声音
有观点认为,这从根本上改变了声音合成的操控方式。不再需要反复调试 prompt 或者找一段「完美的参考音频」,直接拖一个滑块就行。
轻量到极致的编码器
这个编码器本身极其轻量,只有几百万参数,完全可以在网页前端直接运行。
作者 k_means_clusterfuck 已经把它从原始模型里单独剥离出来,上传到了 Hugging Face,还提供了 ONNX 格式的版本: https://huggingface.co/collections/marksverdhei/qwen3-voice-embedding
Qwen 官方把这个模块打包在完整模型里一起发布,每次使用都得下载整个大模型。考虑到 voice embedding 本身的体量和潜力,没有单独宣传这个功能,确实有点可惜。
社区已经在玩什么
- 声音聚类分析:用 k-means 对大量声音做聚类,找到「最适合助眠」的 YouTuber
- 说话人识别:通过嵌入空间判断是真人还是电话语音系统
- 口音修正:把口音映射进向量空间,然后用算术把它改掉
- 播客后期:原来要花几小时调整的音色一致性问题,现在十分钟搞定
边界在哪
有网友实测后提到,两个嵌入向量之间做插值确实能产生可信的混合声音,但嵌入空间并不是完全解耦的——调整音高有时会意外影响音色。
这不是这项技术独有的问题,但说明「数学化声音」这件事仍然有边界:你能合成的,只能是训练数据里已经存在的特征组合。出了分布范围,模型不会凭空造出新东西。
作者计划在 vllm 的 fork 里实现一个功能:在推理过程中逐步线性改变嵌入向量,让语速或情绪在一句话里从平静慢慢变成激动。这个想法能不能落地,还不确定。
最后
你以为声音是灵魂的指纹,结果它只是一个 1024 维的邮编。
从前我们说「嗓音是天赐的」,现在发现天赐的东西也能被压缩、传输、插值、混合。两个陌生人的声音取个平均值,就能造出第三个从未存在过的「人」。
这不是技术在进步,是「独特性」这个概念在贬值。当配音演员还在强调「我的声音有辨识度」时,数学已经证明:辨识度不过是向量空间里的一个偏移量,滑块往左拉 0.3 就能复制。
最讽刺的是,模型只有几百万参数,比你手机里的美颜滤镜还轻。
你的声音不值钱,值钱的是那串能描述它的数字。
原文来源:Reddit r/LocalLLaMA